

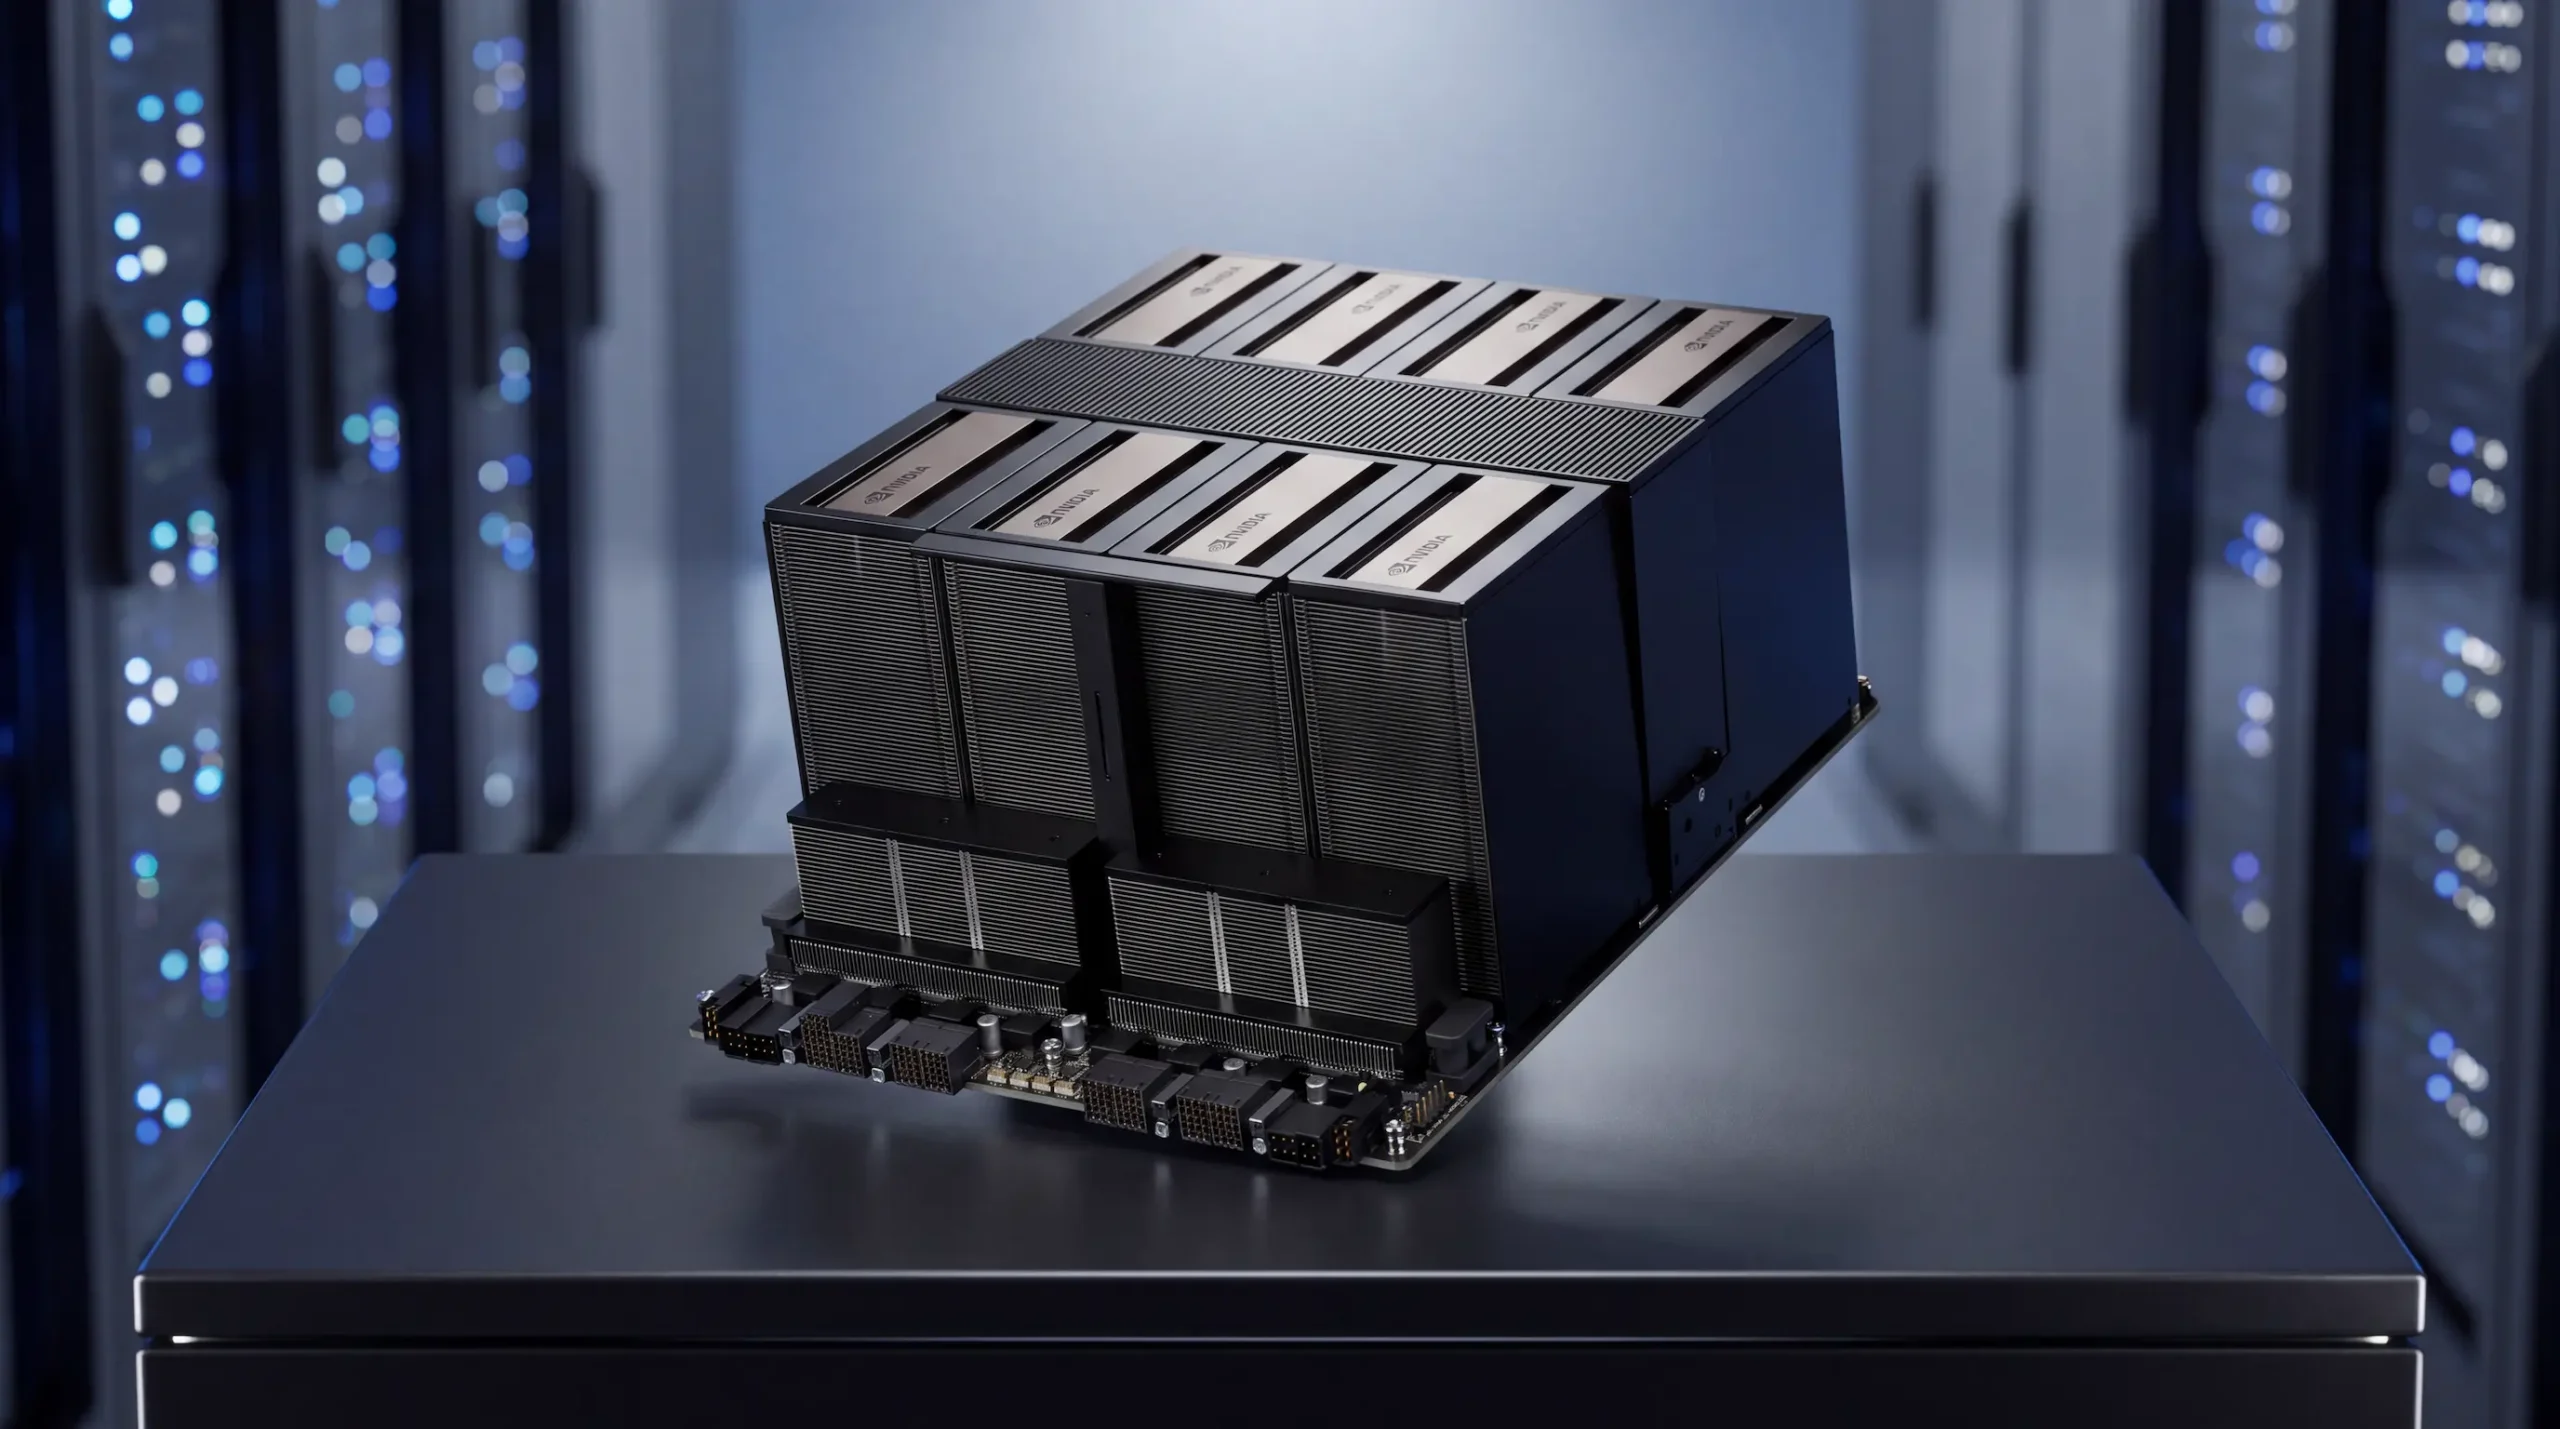
B300 Server sind GPU-beschleunigte Serversysteme für rechenintensive KI-Workloads, insbesondere das Training großer Sprachmodelle, verteiltes Deep Learning und KI-Inferenz. Eine zentrale Hardwareplattform ist NVIDIA HGX B300 mit acht Blackwell Ultra GPUs, die über NVLink der fünften Generation und NVSwitch miteinander verbunden sind. Das HGX B300 Modul bildet dabei die GPU-Compute-Plattform und wird durch Host-Prozessoren, Systemspeicher, NVMe-Storage, Netzwerkadapter sowie Stromversorgungs- und Kühlinfrastruktur zu einem vollständigen Server ergänzt.
Bei der Auswahl eines B300 Servers unterscheiden Unternehmen zwischen dem vollständig integrierten NVIDIA DGX B300 und validierten HGX B300 Servern von OEM-Herstellern. Die jeweiligen Serversysteme unterscheiden sich hinsichtlich CPU-Architektur, PCIe-Topologie, Speicher- und I/O-Kapazität, Netzwerk-Fabric, thermischem Design und Systemvalidierung.
Dieser Artikel erläutert die Architektur und Hardware-Anforderungen von B300 Servern, vergleicht die unterschiedlichen Systemansätze und zeigt, welche Konfigurationen für produktive KI-Workloads und skalierbare Rechenzentrumsinfrastrukturen als KI Server infrage kommen.
Was bedeutet B300 Server in der Praxis?
Die Bezeichnung „B300 Server“ bezieht sich meist auf vollständige Server-Systeme, die um das NVIDIA HGX B300 GPU-Compute-Modul herum gebaut sind. Die NVIDIA HGX B300 Plattform ist kein eigenständiger Server – es ist eine Basisplatine mit acht NVIDIA Blackwell Ultra GPUs, NVLink-5-Interconnect-Fabric und integrierter NVSwitch-Topologie. Ein funktionsfähiger B300 Server erfordert Host-CPUs, Arbeitsspeicher, Storage, Netzwerk, Stromversorgung und thermische Infrastruktur, die um dieses Modul herum assembliert werden.
Vollständige Serversysteme auf Basis von NVIDIA HGX B300 werden sowohl von NVIDIA selbst als auch von OEM-Herstellern angeboten:
- NVIDIA DGX B300: Schlüsselfertiges NVIDIA-Komplettsystem.
- OEM HGX B300 Server: Vollständige Systeme von Serverherstellern, die innerhalb der unterstützten Plattformkonfigurationen individuell ausgestattet werden können.
Beschaffungsentscheidungen beginnen daher mit der Festlegung, ob eine validierte Turnkey-Plattform oder eine spezifische OEM-Konfiguration die erforderliche Performance, das Support-Modell und die kommerziellen Bedingungen liefert. Von NVIDIA HGX B300 Servern mit acht über NVLink und NVSwitch verbundenen Blackwell Ultra GPUs sind Systeme auf Basis des NVIDIA GB300 Grace Blackwell Ultra Superchips architektonisch zu unterscheiden.
B300 Server: Architektur und Systemanforderungen
Das Verständnis dessen, was das HGX B300 beiträgt – und was es vom Host-System benötigt – bestimmt, welche B300-Server-Konfigurationen praktikabel sind. Das HGX B300 Modul integriert acht NVIDIA Blackwell Ultra GPUs mit jeweils 288 GB HBM3E-Speicher, verbunden über NVLink der fünften Generation mit 1,8 TB/s bidirektionaler Bandbreite pro GPU. Die NVSwitch-Fabric verbindet die acht GPUs über eine hochbandbreitige Interconnect-Topologie und ermöglicht die effiziente GPU-zu-GPU-Kommunikation für verteilte Trainings- und Inferenz-Workloads.
Host-Plattform-Anforderungen skalieren mit dem Workload:
- CPU-Auswahl: HGX B300 Server verwenden je nach OEM-Plattform beispielsweise zwei AMD EPYC 9004/9005 oder Intel Xeon 6 Prozessoren. Die CPU-Auswahl muss insbesondere den Anforderungen an Host-Compute, Speicherbandbreite und PCIe-Konnektivität entsprechen.
- Arbeitsspeicher-Kapazität: Die NVIDIA-Referenzarchitektur für zertifizierte HGX B300 Server sieht mindestens 2 TB Host-Arbeitsspeicher vor. Die tatsächlich unterstützte Kapazität und Speicherkonfiguration hängen von der jeweiligen OEM-Plattform ab.
- NVMe-Storage-Durchsatz: Die Anzahl und Kapazität der Server NVMe-SSDs richtet sich nach dem Workload und der Storage-Architektur. GIGABYTE HGX B300 Server der G894-Serie bieten beispielsweise acht 2,5-Zoll-Einschübe für PCIe-Gen5-NVMe-SSDs. Ob lokaler NVMe-Speicher für kontinuierliches Dataset-Streaming ausreicht, hängt von der erforderlichen Datenrate und der Einbindung externer Storage-Systeme ab.
- Netzwerk-Fabric: HGX B300 Server wie die GIGABYTE G894-Serie integrieren acht NVIDIA ConnectX-8 SuperNICs mit bis zu 800 Gb/s pro Adapter für InfiniBand XDR oder Ethernet. Die erforderliche Netzwerkbandbreite hängt insbesondere von der Anzahl der Cluster-Nodes, dem Kommunikationsaufkommen und der verwendeten Parallelisierungsstrategie ab.
Ein HGX B300 Server muss deshalb als Gesamtsystem dimensioniert werden. Neben der GPU-Leistung bestimmen insbesondere die Host-Speicherkonfiguration, der lokale und externe Storage-Durchsatz sowie die Netzwerktopologie, welche Trainings- und Inferenz-Workloads effizient ausgeführt werden können.
Welche CPU-Plattform passt zu B300 Servern?
Die Host-CPU bestimmt PCIe-Lane-Zuteilung, Speichersubsystem-Performance und Plattform-Langlebigkeit. Aktuelle HGX B300 Server werden unter anderem mit folgenden Host-CPU-Plattformen angeboten:
AMD EPYC 9005 Plattformen: Dual-Socket-Konfigurationen mit AMD EPYC Turin 9005 stellen umfangreiche PCIe- und Speicherressourcen bereit. Welche Anschlüsse für NVMe-Storage, Netzwerkadapter und Erweiterungskarten verfügbar sind, bestimmt jedoch die konkrete OEM-Plattform einschließlich ihrer PCIe-Switch-Topologie. DDR5-6400 kann speicherintensive Host-Workloads unterstützen; die tatsächlich erreichbare Leistung hängt von der Speicherbestückung und dem jeweiligen Workload ab.
Intel Xeon 6 Plattformen werden ebenfalls in HGX B300 Servern eingesetzt. Die unterstützten Prozessorvarianten unterscheiden sich je nach Hersteller und Servermodell: Supermicro setzt beim SYS-822GS-NB3RT auf Intel Xeon 6700 mit P-Cores, während GIGABYTE beim G894-SD3-AAX7 auch ausgewählte Xeon-6-Prozessoren mit E-Cores unterstützt. Entscheidend für die Plattformauswahl sind die freigegebenen CPU-Modelle, die Speicherarchitektur und die PCIe-Topologie des jeweiligen Servers.
Die geprüften HGX B300 Server von GIGABYTE sind als Dual-Socket-Systeme ausgelegt. Bei Bestückung mit nur einem Prozessor können laut Hersteller bestimmte PCIe- oder Speicherfunktionen nicht verfügbar sein. Die Entscheidung über die CPU-Bestückung muss deshalb anhand der konkreten Serverarchitektur und der unterstützten Konfigurationen erfolgen.
Plattform-Auswahl hängt von bestehenden Infrastruktur-Standards, Vendor-Beziehungen und Lizenzmodellen ab. Eine Organisation mit AMD-basierten Clustern gewinnt operative Konsistenz durch Fortsetzung mit EPYC; eine auf Intel-Software-Optimierungen festgelegte wählt Xeon. Welche CPU-Plattform für einen HGX B300 Server geeignet ist, hängt neben den unterstützten OEM-Konfigurationen von den Host-Workloads, bestehenden Infrastrukturstandards und betrieblichen Anforderungen ab.
Storage-Konfiguration für B300 Server nach Deployment-Szenario
Storage-Anforderungen divergieren stark zwischen Training- und Inferenz-Deployments.
Training-optimierter B300 Server Storage: Verteiltes Training konsumiert Datasets kontinuierlich. Batch-Größen im Hunderte-Samples-pro-GPU-Bereich erfordern anhaltenden sequenziellen Lesedurchsatz, den Festplatten nicht liefern können. Eine Training-Konfiguration benötigt eine auf Dataset-Größe, Zugriffsmuster und Datenrate abgestimmte Storage-Architektur. Lokale PCIe-Gen5-NVMe-SSDs können für Dataset-Caching und temporäre Trainingsdaten eingesetzt werden. Anzahl, Kapazität und RAID-Konfiguration hängen von der jeweiligen OEM-Plattform sowie den Anforderungen an Durchsatz und Datenverfügbarkeit ab. Checkpoints und Model-State sollten entsprechend der Wiederherstellungsstrategie regelmäßig auf persistentem Storage gesichert werden. Das Sicherungsintervall richtet sich nach Workload, Checkpoint-Größe und tolerierbarem Rechenzeitverlust.
Inferenz-optimierter B300 Server Storage: Inferenz-Serving lädt Modellgewichte typischerweise in den GPU-Speicher und verarbeitet anschließend Anfragen. Storage wird insbesondere für Modellbereitstellung, Modellwechsel, Versionierung und gegebenenfalls das Nachladen von Daten benötigt. Anzahl und Kapazität der NVMe-SSDs richten sich nach Modellgröße, Ladezeiten und Datenzugriffsmustern. Schreibintensive Logging- oder Persistenz-Workloads erfordern eine entsprechend ausgelegte SSD-Endurance.
Netzwerk-Fabric für Multi-Node B300 Server Cluster
Einzelne B300 Server operieren standalone für Inferenz oder kleinformatiges Training. Cluster erfordern Backend-Netzwerk:
Ethernet oder InfiniBand: HGX B300 Server können über leistungsfähige Ethernet- oder InfiniBand-Fabrics für verteilte KI-Workloads verbunden werden. GIGABYTE unterstützt beispielsweise InfiniBand XDR mit bis zu 800 Gb/s oder duales 400-GbE über ConnectX-8. Ethernet-Konfigurationen können RoCE für RDMA-Kommunikation nutzen. Die Auswahl hängt von der Clusterarchitektur, der erforderlichen Kommunikationsleistung und der vorhandenen Netzwerkinfrastruktur ab.
Multi-Rail-Konfigurationen nutzen mehrere Netzwerkverbindungen, um Kommunikationslast zu verteilen und die verfügbare Bandbreite zu erhöhen. Redundanz und Fehlertoleranz hängen von der konkreten Netzwerk- und Switching-Topologie ab.
Thermisches Design und Stromversorgung für B300 Server
HGX B300 Server weisen aufgrund ihrer acht Blackwell Ultra GPUs eine hohe Leistungsaufnahme auf. NVIDIA spezifiziert für das vollständige DGX B300 System rund 14 kW. Die tatsächliche Leistungsaufnahme eines OEM-Servers hängt von GPU-Leistungsprofil, Host-Prozessoren, Speicher, Netzwerk und weiteren Komponenten ab. Stromversorgung und Kühlung müssen anhand der konkreten Herstellerspezifikationen dimensioniert werden.
Kühlarchitektur
Luftgekühlte HGX B300 Server benötigen einen entsprechend dimensionierten Luftstrom und eine geeignete Rack- und Rechenzentrumskühlung. Die zulässigen Einlasstemperaturen und Luftstromanforderungen sind den Spezifikationen des jeweiligen OEM-Systems zu entnehmen. GIGABYTE gibt für das G894-ZD3-AAX7 beispielsweise einen Betriebstemperaturbereich von 10 bis 30 °C an.
Flüssigkeitskühlung kann die Abfuhr hoher Wärmelasten unterstützen und höhere Rack-Leistungsdichten ermöglichen. Wie viel Wärme über den Kühlmittelkreislauf abgeführt wird, hängt von der jeweiligen Systemarchitektur und den flüssigkeitsgekühlten Komponenten ab. Für Liquid Cooled Server bzw. Direct-to-Chip-Lösungen ist eine geeignete Kühlmittelversorgung einschließlich der erforderlichen Verteilungs- und Überwachungstechnik notwendig.
Netzteil-Dimensionierung und Redundanz
HGX B300 Server verwenden herstellerabhängige Netzteilarchitekturen mit mehreren Hochleistungsnetzteilen. Beispielsweise integriert GIGABYTE beim G894-ZD3-AAX7 zwölf 3.000-W-Netzteile, während Supermicro beim AS-8126GS-NB3RT sechs 6.600-W-Netzteile in einer redundanten 3+3-Konfiguration einsetzt. Die tatsächlich verfügbare Leistung und vollständige Redundanz hängen von der Systemkonfiguration, Eingangsspannung und Auslastung ab.
OEM HGX B300 Server
OEM HGX B300 Server sind mit unterschiedlichen Ausstattungen erhältlich und können innerhalb der vom Hersteller unterstützten Konfigurationsmöglichkeiten an individuelle Anforderungen angepasst werden..
OEM HGX B300 Server-Systeme: Server-Hersteller integrieren das HGX B300 Modul mit getesteten Host-Plattformen, Firmware und Support. Vorteile umfassen pre-validierte Hardware-Kompatibilität und thermische Profile, herstellerabhängige Support- und Serviceleistungen, auf das jeweilige Serversystem abgestimmte Firmware- und BIOS-Versionen. Die Gesamtkosten hängen von Systemkonfiguration, Integrationsaufwand, Supportumfang und Beschaffungskonditionen ab. Validierte OEM-Systeme reduzieren den Aufwand für die eigene Hardwareintegration und bieten definierte Support- und Wartungsprozesse.
Kundenspezifisch konfigurierte HGX B300 Server: Unternehmen und Rechenzentren können HGX B300 Server auf Basis geeigneter OEM-Plattformen entsprechend den Workload-Anforderungen konfigurieren. Innerhalb der vom Hersteller unterstützten Konfigurationsmöglichkeiten lassen sich beispielsweise unterstützte Host-Prozessoren auswählen sowie Arbeitsspeicher und NVMe-SSDs entsprechend den Herstellerspezifikationen bestücken. Die Auswahl ist dabei an die technischen Vorgaben der jeweiligen Serverplattform gebunden. Insbesondere Chassis, Kühlarchitektur, Stromversorgung und Firmware-Kompatibilität müssen auf das HGX B300 Modul und das Gesamtsystem abgestimmt sein. Die gewählte Konfiguration muss den Herstellervorgaben entsprechen. Kompatibilität und Verfügbarkeit der gewünschten Ausstattung sollten vor der Bestellung geprüft werden.
Server-hardware.com verfügt über langjährige Erfahrung in der Konfiguration, Integration und Bereitstellung leistungsstarker GPU-Server für professionelle KI- und HPC-Infrastrukturen. Aus zahlreichen realisierten Kundenprojekten kennen unsere Server-Experten die Anforderungen an die Abstimmung von GPU-Architektur, CPU-Plattform, PCIe-Topologie, Speicheranbindung, Netzwerk-Fabric sowie Stromversorgung und Kühlung. Diese Praxiserfahrung fließt in die technische Planung, Dimensionierung und Integration individueller B300 Server auf Basis der NVIDIA HGX B300 Plattform ein.
Management, Monitoring und Remote-Administration von B300 Servern
HGX B300 Server verfügen über mehrere Management- und Monitoring-Schnittstellen. Der Baseboard Management Controller (BMC) ermöglicht die hardwareseitige Remote-Administration, beispielsweise über Redfish oder IPMI. GPU-Telemetrie, Zustandsüberwachung und Diagnose können über NVIDIA Data Center GPU Manager (DCGM) erfolgen. Für die übergeordnete Clusterverwaltung können zusätzliche Softwarelösungen wie NVIDIA Base Command Manager eingesetzt werden. Ein zentrales Monitoring muss die relevanten Daten aus Host-System, GPUs, NVLink/NVSwitch, Netzwerk und weiteren Infrastrukturkomponenten zusammenführen. Welche Schnittstellen und Management-Funktionen verfügbar sind, hängt vom OEM-System und der eingesetzten Software ab. OEM-Systeme liefern typischerweise integrierte Dashboards, die beide Management-Planes konsolidieren.
Wann NVIDIA DGX B300 statt anderer B300 Server einsetzen?
Der NVIDIA DGX B300 ist ein vollständiges, von NVIDIA validiertes Serversystem mit acht Blackwell Ultra GPUs, zwei Intel Xeon Platinum 6776P Prozessoren, standardmäßig 2 TB Arbeitsspeicher, NVMe-Storage und einem integrierten NVIDIA-Software-Stack. Er wird validiert ausgeliefert und vollständig von NVIDIA supported. DGX B300 bietet eine von NVIDIA validierte Systemarchitektur mit definierten Software- und Supportleistungen. OEM HGX B300 Server können je nach Konfiguration, Software-Stack und Supportmodell eine Alternative zum DGX B300 darstellen. Leistungsfähigkeit und Gesamtkosten müssen anhand vergleichbarer Systemkonfigurationen und konkreter Workloads bewertet werden.
NVIDIA HGX B300, DGX B300 und GB300 NVL72: Was ist der Unterschied?
NVIDIA verwendet die Bezeichnungen HGX B300, DGX B300 und GB300 NVL72 für unterschiedliche Systemarchitekturen. Während HGX B300 die Acht-GPU-Basisplatine bezeichnet, ist DGX B300 ein vollständiges, von NVIDIA entwickeltes Server-System auf Basis dieser Plattform. GB300 NVL72 hingegen ist eine Rack-Scale-Architektur mit 72 Blackwell Ultra GPUs und 36 Grace CPUs, die über ein gemeinsames NVLink-Netzwerk verbunden sind. Bei der Beschaffung sollte deshalb eindeutig zwischen individuell konfigurierten HGX B300 Servern, NVIDIA DGX B300 Komplettsystemen, Multi-Node-Clustern und GB300 NVL72 Rack-Scale-Systemen unterschieden werden.
Die richtige B300 Server Konfiguration für produktive KI-Workloads wählen
Die Wahl zwischen NVIDIA DGX B300 und OEM HGX B300 Servern hängt aus unserer Sicht von operativen Prioritäten, Budget und Deployment-Skala ab.
DGX B300 bevorzugen, wo: Turnkey-Deployment, einheitlicher Support und pre-validierte Performance wichtiger sind als Komponenten-Kosten; KI-Team-Kapazität auf Modell-Entwicklung statt Infrastruktur-Tuning fokussiert ist; Vendor-Beziehung mit NVIDIA Beschaffung vereinfacht.
OEM HGX B300 Systeme bevorzugen, wo: bestehende Server-Vendor-Beziehungen kommerzielle und Support-Vorteile bieten; interne IT Multi-Vendor-Infrastruktur routinemäßig managed; validierte Konfigurationen erforderlich sind, aber Komponenten-Auswahl innerhalb des validierten Bereichs akzeptabel ist.
NVIDIA DGX B300 und OEM HGX B300 Server basieren auf derselben GPU-Plattform. Unterschiede bei Host-Prozessoren, Arbeitsspeicher, Storage, Netzwerkanbindung, Leistungsprofilen und Software können sich jedoch auf die tatsächliche Workload-Performance auswirken.
B300 Server entsprechend dem Workload dimensionieren
Die Auswahl von CPU-Count, Speicherkapazität, Storage-Durchsatz und Netzwerk-Fabric für einen HGX B300 Server erfordert einen Abgleich der Systemressourcen mit Workload-Anforderungen. Maximal unterstützte Kapazität bietet Design-Headroom, definiert aber nicht die wirtschaftliche Konfiguration. Training-Workloads erfordern andere Balancen als Inferenz-Serving; Multi-Node-Cluster verschieben Investition zu Backend-Netzwerk; Single-Node-Deployments erfordern eine auf den jeweiligen Workload abgestimmte lokale oder externe Storage-Anbindung. Storage-Entscheidungen hängen von Dataset-Größe, Zugriffsmuster und Training-Batch-Size ab. Netzwerkadapter-Auswahl folgt daraus, ob das System standalone operiert oder an verteilten Workloads teilnimmt. Speicherkapazität skaliert mit Preprocessing-Pipeline-Komplexität und Multi-Tenant-Inferenz-Concurrency. Strom- und Kühlinfrastruktur muss nicht den Idle-State unterstützen, sondern anhaltenden Volllast-Betrieb.
Bei server-hardware.com unterstützen wir Unternehmen bei der Auswahl und Konfiguration passender HGX B300 Server. Unsere Server-Experten beraten Systemintegratoren, KI-Infrastruktur-Teams und Rechenzentrumsbetreiber bei der Auswahl der CPU-Plattform, der Storage-Architektur, der Netzwerk-Fabric und der Kühlung. Ob einzelne B300 Server oder größere Multi-System-Deployments: Wir unterstützen Sie bei der technischen Planung und erstellen individuelle Angebote – auch mit erweiterten Garantie- und Finanzierungsoptionen.
Technische Quellen:
 Online Marketing Managerin