

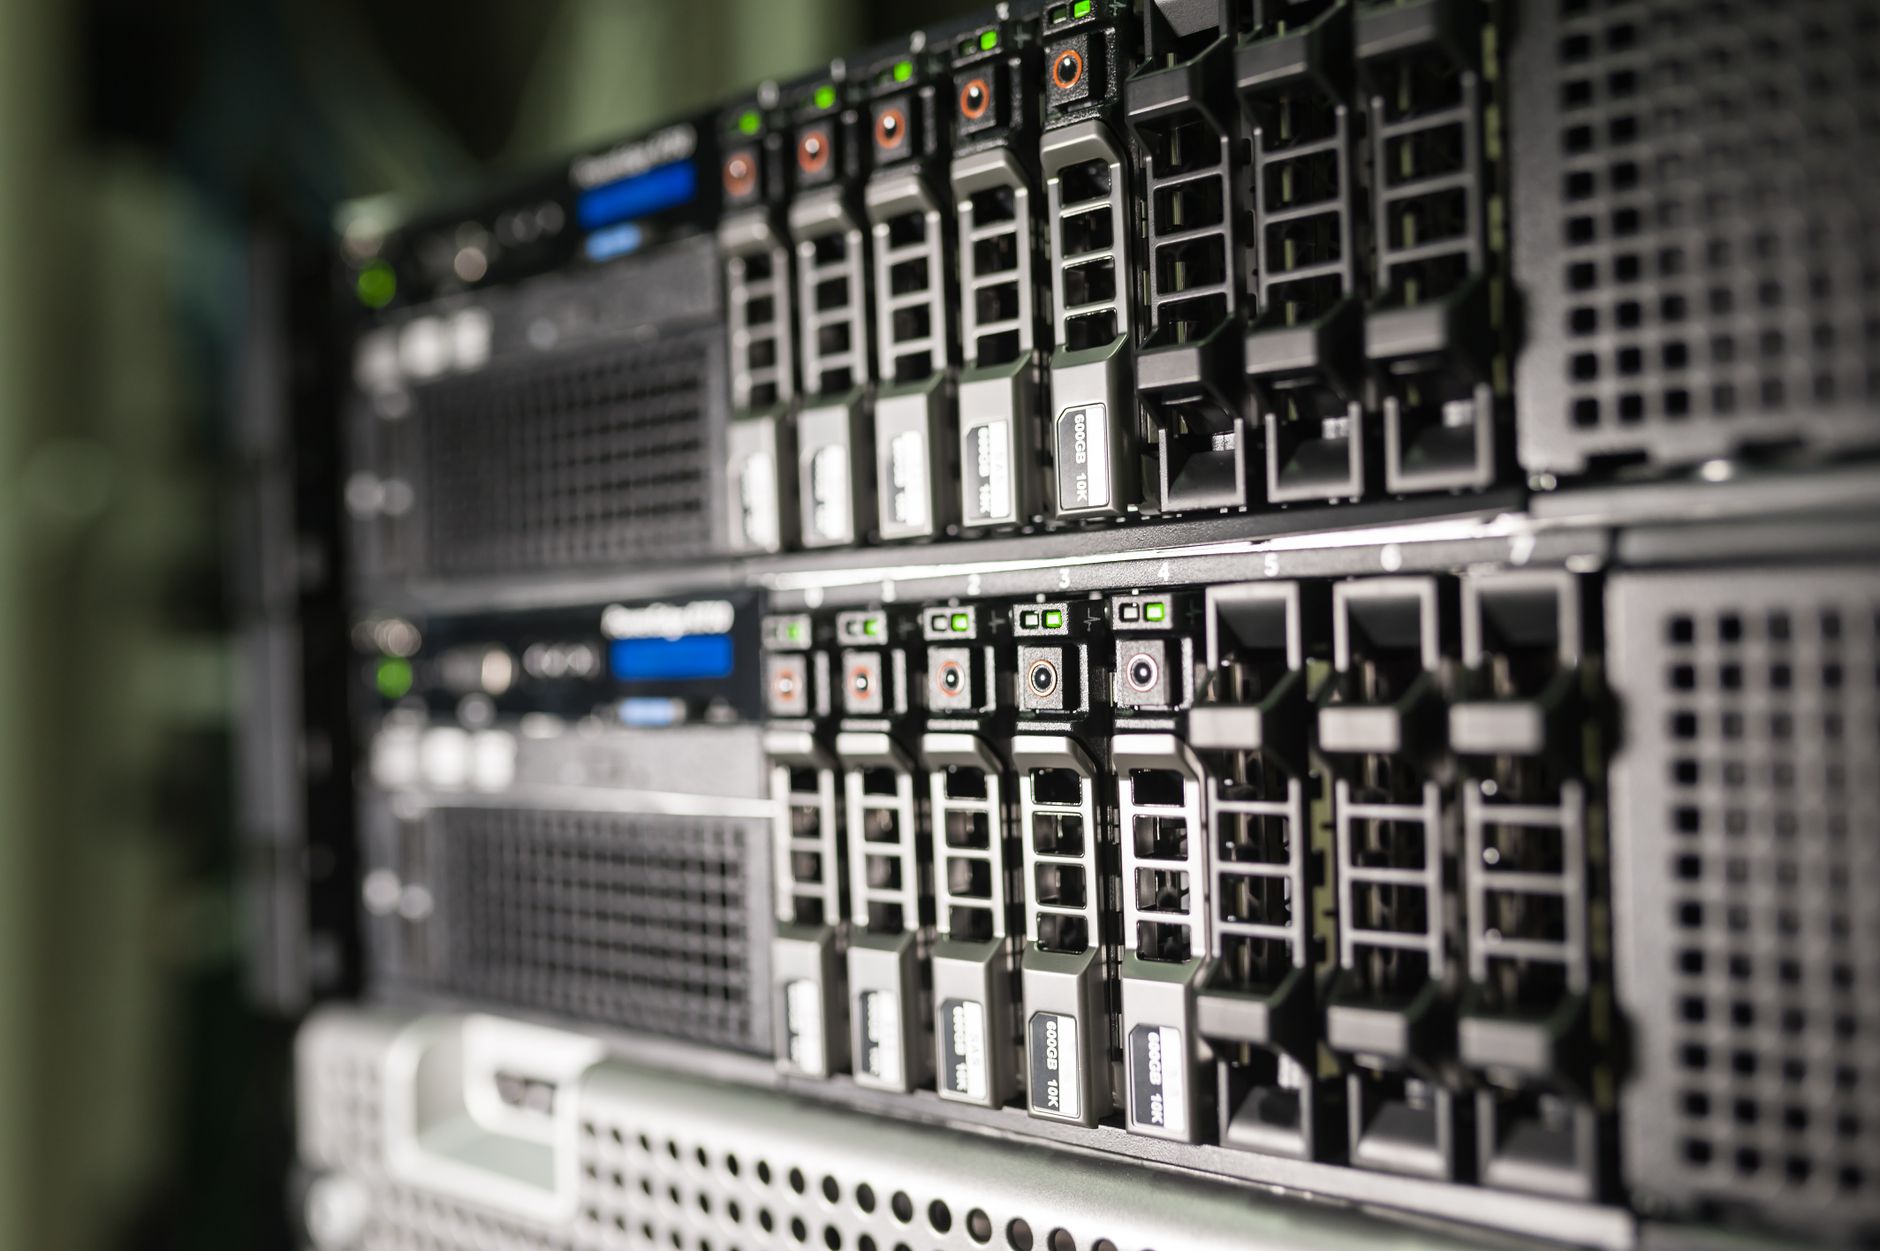
Ein JBOD – „Just a Bunch of Disks“ – ist eine Disk-Enclosure-Architektur, die einzelne Laufwerke direkt an ein Hostsystem oder einen externen Storage-Controller durchreicht, ohne Hardware-RAID-Operationen durchzuführen. Der zentrale Unterschied zwischen JBOD und RAID liegt darin, wo die Storage-Logik und Redundanz umgesetzt werden. Anders als intelligente Storage-Arrays mit eingebauten RAID-Prozessoren funktioniert ein JBOD-Gehäuse als transparentes Erweiterungs-Chassis: Die Laufwerke erscheinen dem Host als separate Block-Devices, und die gesamte Storage-Logik – Pooling, Redundanz, Tiering – wird durch Software oder einen externen Controller übernommen. Das macht JBOD zur flexibelsten und kosteneffizientesten Option, wenn die Intelligenz auf Host-Ebene angesiedelt sein soll und nicht im Gehäuse – insbesondere für Software-Defined-Storage-Plattformen, Hyperconverged Infrastructure und kapazitätsorientierte Workloads, bei denen Hardware-RAID-Overhead unnötig ist.
IT-Infrastrukturplaner, die Storage-Erweiterungen evaluieren, sehen sich wiederholt mit der Frage konfrontiert: Soll das Gehäuse eigene RAID-Logik mitbringen oder soll das Hostsystem die Laufwerke steuern? Die Antwort hängt davon ab, ob der Workload von Hardwarebeschleunigung profitiert, ob die Storage-Software direkten Plattenzugriff erwartet und ob die Architektur Kapazität unabhängig von Rechenressourcen skalieren muss. Dieser Artikel erklärt, wie sich JBOD von RAID-Arrays und anderen Storage-Architekturen unterscheidet, wann direkte Plattenpräsentation Hardware-RAID übertrifft und welche Einsatzszenarien die zusätzliche hostseitige Komplexität rechtfertigen.
JBOD und RAID: Was bedeutet JBOD architektonisch?
JBOD ist kein RAID-Level. Es ist eine Gehäuse-Design-Philosophie: Das Chassis stellt physische Montage, Stromverteilung, Kühlung und SAS-Expander-Backplane-Konnektivität bereit, aber keinen RAID-Controller. Jedes Laufwerk im Gehäuse verbindet sich über einen SAS-Expander mit dem HBA (Host Bus Adapter) des Hosts und erscheint als individuelles Gerät – /dev/sda, /dev/sdb, /dev/sdc unter Linux zum Beispiel. Das Host-Betriebssystem oder die Storage-Software sieht die rohen Laufwerke und entscheidet, wie sie genutzt werden.
Ein Hardware-RAID-Controller aggregiert demgegenüber Laufwerke zu logischen RAID-Volumes, bevor der Host sie sieht. Ein sechs Platten umfassendes RAID-6-Array kann dem Betriebssystem als einzelnes 20-TB-Volume erscheinen; der Controller übernimmt Paritätsberechnung, Write-Buffering, Cache-Management und Rebuild-Operationen transparent. JBOD verlagert diese gesamte Verantwortung auf Software. Wenn Redundanz benötigt wird, muss der Host sie implementieren – über Linux mdadm, ZFS, Windows Storage Spaces, VMware vSAN oder eine verteilte Storage-Schicht wie Ceph oder GlusterFS.
Der architektonische Unterschied ist besonders relevant, wenn die Storage-Software direkten Device-Zugriff erwartet. ZFS beispielsweise verwaltet eigene Redundanz, Checksumming und Copy-on-Write-Verhalten; wird eine Hardware-RAID-Schicht unter ZFS eingefügt, schränkt das dessen direkte Sicht auf die einzelnen Laufwerke und Fehlermöglichkeiten ein. Software-Defined-Storage-Plattformen gehen ebenfalls davon aus, dass sie die Platten kontrollieren: Ein RAID-Controller zwischen Software und Laufwerken erzwingt doppeltes Buffering, führt zu undurchsichtigen Fehlermodi und verhindert, dass die Storage-Schicht intelligente Platzierungsentscheidungen auf Basis individueller Laufwerksgesundheit oder Performance treffen kann.
JBOD-Gehäuse nutzen typischerweise SAS-Expander, um die Konnektivität von ein oder zwei externen SAS-Ports auf 12, 24, 45 oder 60 interne Laufwerksschächte aufzufächern. Ein Dual-Controller-JBOD erlaubt zwei separaten Hosts oder HBAs gleichzeitigen Zugriff auf dieselben Laufwerke für Failover; jeder Controller hat einen eigenen SAS-Pfad zum Expander-Backplane, und die Host-Software übernimmt Path-Selection und Failover-Logik. Diese Multipathing-Fähigkeit ist essentiell für hochverfügbare Storage-Cluster, bei denen ein einzelner Host-Ausfall den Zugriff auf die Platten nicht blockieren darf.
JBOD vs. RAID-Arrays: Wenn direkter Plattenzugriff Hardware-RAID übertrifft
Hardware-RAID-Arrays und JBOD-Gehäuse lösen unterschiedliche Probleme. Ein RAID-Controller lagert Redundanzberechnungen von der Host-CPU aus, stellt batteriegepufferten Write-Cache für transaktionale Workloads bereit und präsentiert dem Betriebssystem eine vereinfachte Storage-Ansicht. JBOD bietet maximale Flexibilität: Die Host-Software kann Laufwerke stripen, spiegeln oder unabhängig belassen, das Redundanzschema ohne Hardware-Constraints ändern und Kapazität Laufwerk für Laufwerk hinzufügen oder entfernen.
Hardware-RAID ist angemessen, wenn das Host-Betriebssystem oder die Applikation RAID-unaware ist, wenn vorhersagbare Schreiblatenz von batteriegepuffertem Cache abhängt oder wenn Boot-from-SAN Controller-verwaltete LUNs erfordert. Ein Datenbankserver auf Bare Metal mit direkt angeschlossenem Storage profitiert von der Fähigkeit eines RAID-Controllers, zufällige Write-Bursts in Cache aufzunehmen und sie während Leerlaufphasen sequenziell zu destagen. Die XOR-Engine des Controllers beschleunigt RAID-5- oder RAID-6-Paritätsberechnung und reduziert CPU-Overhead.
JBOD ist angemessen, wenn die Storage-Software rohe Geräte erwartet, wenn Kapazität unabhängig von Redundanz-Overhead skalieren muss oder wenn der Workload lesedominant genug ist, dass Write-Cache-Beschleunigung unnötig ist. Ein Medienstreaming-Server, der 4K-Videodateien speichert, benötigt keine Sub-Millisekunden-Schreiblatenz; er benötigt maximale nutzbare Kapazität pro Höheneinheit. ZFS oder Ceph können diese Kapazität effizienter verwalten als ein Hardware-RAID-Controller, weil sie das Datenlayout verstehen und Platzierung sowie Rebuild-Operationen auf Applikationsebene optimieren können.
Software-Defined-Storage-Plattformen – VMware vSAN, Nutanix, Microsoft Storage Spaces Direct, Red Hat Ceph Storage – setzen häufig auf JBOD beziehungsweise direkten Laufwerkszugriff anstelle von Hardware-RAID. Diese Plattformen implementieren eigene Redundanz über mehrere Knoten hinweg; wird in jedem Knoten ein RAID-Controller eingefügt, zwingt man die Software, Daten zu schützen, die bereits durch das Gehäuse geschützt sind – das verschwendet Kapazität und verkompliziert Fehlerwiederherstellung. JBOD erlaubt der Software, Laufwerksausfälle direkt zu sehen, Daten auf andere Knoten zu verteilen und eine ausgefallene Platte zurückzuziehen, ohne auf einen Enclosure-Rebuild-Zyklus warten zu müssen.
Objektspeichersysteme folgen derselben Logik. Ein Object Store mit Erasure Coding über 12 Storage-Knoten benötigt nicht in jedem Knoten Hardware-RAID-6; der verteilte Erasure Code liefert Redundanz effizienter. JBOD-Gehäuse in jedem Knoten legen die Laufwerke direkt frei, und der Platzierungsalgorithmus des Object Stores verteilt Daten über Knoten und Laufwerke entsprechend seinem eigenen Durability-Ziel. Ein einzelner Laufwerksausfall wird repariert, indem das Objekt von anderen Knoten neu kodiert wird, nicht durch Rebuild eines lokalen RAID-Sets.
JBOD vs. DAS, NAS und SAN: Wo JBOD in der Storage-Hierarchie einzuordnen ist
JBOD ist eine Form von Directly Attached Storage (DAS): Das Gehäuse verbindet sich Punkt-zu-Punkt per SAS-Kabel mit einem Host, nicht über ein gemeinsames Netzwerk. Anders als NAS Speicher (Network-Attached Storage) oder SAN Speicher (Storage Area Network) verfügt ein JBOD über keine netzwerkorientierten Protokolle – kein NFS, SMB, iSCSI oder Fibre Channel Target Capability. Der HBA des Hosts muss physisch mit dem JBOD verkabelt sein, und nur Systeme mit direkter SAS-Verbindung können auf die Laufwerke zugreifen.
Diese architektonische Einfachheit ist zugleich Einschränkung und Stärke. JBOD kann Storage nicht an Dutzende unabhängiger Clients ausliefern, wie es ein NAS-Appliance kann; es ist an den Host gebunden, mit dem es verbunden ist. Aber JBOD vermeidet auch den Protokoll-Overhead, die Netzwerklatenz und die Komplexität von Shared Storage. Ein Single-Host-Workload – eine Videobearbeitungsworkstation, ein Backup-Server, ein Hyperconverged-Knoten – performt oft besser mit lokal per SAS angeschlossenem JBOD als mit iSCSI- oder NFS-Mounts über ein 10-GbE-Netzwerk, weil der I/O-Pfad kürzer ist und der Host vollständige Sichtbarkeit auf Laufwerksgesundheit und Performance hat.
JBOD wird häufig als Backend-Erweiterung für SAN- und NAS-Systeme eingesetzt. Ein Storage-Controller mit TrueNAS, OpenMediaVault oder einem kommerziellen NAS-Betriebssystem verbindet sich per SAS-HBAs mit JBOD-Gehäusen und exportiert die gepoolte Kapazität über das Netzwerk als NFS- oder SMB-Shares. Das JBOD stellt die rohe Kapazität bereit; der Controller liefert Netzwerk-Intelligenz, Caching, Snapshot-Management und Multi-Client-Zugriff. Diese Trennung erlaubt unabhängige Kapazitätsskalierung: Zusätzliche JBOD-Shelves können hinzugefügt werden, ohne den Controller zu ersetzen, solange HBA und SAS-Topologie die hinzugefügte Laufwerksanzahl unterstützen.
Wann ist JBOD statt RAID die richtige Storage-Architektur?
JBODs sind die richtige Wahl, wenn Storage-Intelligenz auf Software-Ebene angesiedelt sein soll, wenn Kapazität flexibel skalieren muss oder wenn der Workload die Kosten und Komplexität eines Hardware-RAID-Controllers nicht rechtfertigt. Mehrere Deployment-Muster machen JBOD architektonisch überlegen gegenüber intelligenten Arrays:
Software-Defined-Storage-Plattformen sind auf direkten Plattenzugriff angewiesen. VMware vSAN, Ceph und ähnliche Systeme gehen davon aus, dass sie Drive-Layout kontrollieren, Metadaten verwalten und Ausfälle auf Cluster-Ebene handhaben. Ein Hardware-RAID-Controller zwischen Software und Laufwerken verbirgt Ausfälle vor dem Cluster, verhindert feingranulares Kapazitätsmanagement und erzwingt doppelte Write Amplification. JBOD erlaubt der Software, jedes Laufwerk zu sehen, Replikate intelligent zu platzieren und Kapazität über Knoten hinweg zu verwalten, ohne Enclosure-Level-Constraints.
Cold Storage und Archivierungs-Tiers priorisieren nutzbare Kapazität vor Performance. Ein 4U-JBOD mit 60 großkapazitiven SATA-Laufwerken ermöglicht eine hohe Speicherdichte und niedrige Kosten pro TB. Der Workload – Backup-Ziele, Videoarchive, Compliance-Retention – ist Write-Once-Read-Rarely; der Wert liegt in Kapazität, nicht in cache-beschleunigtem Random-I/O. Hardware-RAID-Overhead (doppelte Parität, Hot-Spare-Reservation) reduziert nutzbare Kapazität; JBOD mit Software-RAID-6 oder Erasure Coding kann die erforderliche Redundanz softwareseitig bereitstellen.
Medienproduktions- und Postproduktionsumgebungen handhaben massive sequenzielle Dateien, die Hardware-RAID-Cache überlasten. Eine 4K- oder 8K-Videobearbeitungsworkstation, die mehrere unkomprimierte Timelines streamt, profitiert stärker von aggregierter Laufwerksbandbreite als von einem 4-GB-Cache eines RAID-Controllers. JBOD mit Software-RAID-0 über NVMe- oder SAS-SSDs liefert höheren sequenziellen Durchsatz als die meisten Hardware-RAID-Controller, und das RAM der Workstation fungiert als effektiver Read-Cache.
Hyperconverged-Infrastructure-Knoten kombinieren Compute und Storage im selben Chassis. Jeder Knoten führt Applikations-VMs auf lokalen CPU- und GPU-Ressourcen aus und trägt seine lokalen Laufwerke zu einem verteilten Storage-Pool bei. JBOD erlaubt der Hyperconverged-Software (Nutanix AHV, VMware vSAN, Cisco HyperFlex), die Laufwerke direkt zu verwalten; ein Hardware-RAID-Controller pro Knoten fügt Kosten hinzu, ohne Wert zu schaffen, weil Redundanz bereits durch die verteilte Architektur garantiert ist.
Test- und Entwicklungscluster benötigen flexible, kosteneffiziente Kapazität, die schnell rekonfiguriert werden kann. JBOD erlaubt, einzelne Laufwerke verschiedenen VMs zuzuweisen, für neue Testfälle neu zu partitionieren oder zu ersetzen, ohne ein gesamtes RAID-Set neu aufzubauen. Ein Development-Kubernetes-Cluster könnte JBOD mit lokalen PersistentVolumes nutzen, die von einem CSI-Treiber verwaltet werden, und vermeidet so die Kosten von Enterprise-SAN-Infrastruktur für ephemere Workloads.
Das Muster ist konsistent: JBOD ist die richtige Architektur, wenn die Host-Software ausgereift genug ist, um Laufwerke selbst zu verwalten, wenn Kapazitätsökonomie Performance-Beschleunigung überwiegt oder wenn das Deployment-Modell Redundanz über Knoten verteilt, anstatt sie in jedem Gehäuse zu konzentrieren. Für traditionelle Enterprise-Workloads, bei denen Betriebssystem und Applikation ein einzelnes Block-Device mit vorhersagbarer Latenz erwarten, bleibt Hardware-RAID angemessen.
JBOD-Einschränkungen und Trade-offs gegenüber RAID
JBODs architektonische Einfachheit bringt Verantwortlichkeiten mit sich, die Hardware-RAID-Controller automatisch handhaben. Diese Trade-offs zu erkennen hilft zu entscheiden, ob JBOD für ein gegebenes Deployment passt:
Keine Redundanz auf Enclosure-Ebene. Ein Laufwerksausfall in einem JBOD ist schlicht ein Laufwerksausfall; das Gehäuse schützt benachbarte Laufwerke nicht und beginnt nicht, Daten auf einem Hot Spare zu rebuilden. Wenn die Host-Software kein RAID oder keine Replikation implementiert, sind die Daten auf dem ausgefallenen Laufwerk verloren. Im Gegensatz dazu kann ein RAID-Controller auf einen Hot Spare failovern und sofort mit dem Rebuild beginnen, oft ohne dass das Host-Betriebssystem den Ausfall bemerkt, bis der Rebuild abgeschlossen ist.
Host-Abhängigkeit für gesamte Storage-Logik. JBOD verlagert Paritätsberechnung, Write-Buffering, Rebuild-I/O und Gesundheitsüberwachung auf Host-CPU und Storage-Software. Ein Server, der ZFS RAID-Z2 über 20 Laufwerke in einem JBOD betreibt, wendet CPU-Zyklen für Paritätsberechnung auf, die ein RAID-Controller auslagern würde. Das ist auf modernen EPYC- oder Xeon-Plattformen mit AES-NI-Beschleunigung und hohen Core-Counts weniger relevant, stellt aber dennoch messbaren Overhead auf CPU-beschränkten Systemen dar.
Begrenzte Write-Beschleunigung. Hardware-RAID-Controller mit batteriegepuffertem Cache können Schreibvorgänge sofort bestätigen und sie asynchron auf Platte destagen, was Schreiblatenz für transaktionale Workloads reduziert. JBOD hat keinen Write-Cache; jeder Schreibvorgang muss auf der physischen Platte abgeschlossen sein, bevor er bestätigt wird. Software-RAID auf JBOD kann Host-RAM als Write-Back-Cache nutzen, aber ein Stromausfall ohne USV riskiert Datenverlust, außer der Host verfügt über Persistent Memory oder eine ähnliche batteriegepufferte Lösung.
Komplexität von Multipathing und Failover. Dual-Controller-JBOD-Deployments erfordern, dass der Host Path-Failover verwaltet, Path-Ausfälle erkennt und I/O korrekt verteilt. Fehlkonfigurierte Multipath-Setups verursachen Datenkorruption; Path-Thrashing unter hoher Last verursacht Performance-Instabilität. Ein Hardware-RAID-Controller mit Active-Active-Firmware handhabt das intern und präsentiert dem Host ein einzelnes, stabiles Gerät.
Rebuild-Last auf Host-Ressourcen. Wenn ein Laufwerk in einem JBOD-backed ZFS-Pool oder Ceph-Cluster ausfällt, verbraucht der Rebuild-Prozess Host-CPU, Arbeitsspeicher und I/O-Bandbreite. Ein Hardware-RAID-Rebuild läuft auf dem dedizierten Prozessor des Controllers, kann aber weiterhin mit Applikations-I/O um verfügbare Storage-Ressourcen konkurrieren. Für latenzempfindliche Produktionssysteme kann das relevant sein: Ein RAID-Controller kann Rebuild-I/O drosseln, um Foreground-Performance zu schützen, während Software-RAID manuelles Tuning erfordern kann, um zu verhindern, dass Applikationen während des Rebuilds ausgehungert werden.
Diese Einschränkungen sind keine inhärenten Mängel; sie sind Trade-offs. JBOD gibt Ihnen Flexibilität, Transparenz und Kosteneinsparungen auf Kosten der Eigenständigkeit. Wenn die Host-Software fähig ist und der Workload die hinzugefügte Verantwortung toleriert, liefert JBOD bessere Ökonomie und bessere Skalierbarkeit als intelligente Arrays. Wenn das Deployment Hands-off-Betrieb, vorhersagbare Latenz unabhängig von Ausfällen oder Kompatibilität mit Storage-unawareen Betriebssystemen benötigt, bleibt Hardware-RAID die sicherere Wahl.
JBOD-Kapazität und Redundanz entsprechend dem Workload dimensionieren
Die Dimensionierung eines JBOD-Deployments erfordert die Balance zwischen aggregiertem Durchsatz, Redundanz-Overhead, Rebuild-Zeit, Stromverbrauch und der Fähigkeit des Hosts, den resultierenden Storage-Pool zu verwalten. Ein 60-Laufwerke-JBOD klingt nach maximaler Effizienz, aber wenn die Host-CPU nicht mit Rebuild-I/O Schritt halten kann oder der Workload kein PB rohe Kapazität benötigt, performt oft ein kleineres Gehäuse mit dichteren Laufwerken oder schnelleren Medien besser.
Für kapazitätsorientierte Deployments – Backup-Ziele, Videoarchive, Log-Retention – steht die Berechnung nutzbarer TB nach Redundanz im Zentrum. Ein 45-Bay-JBOD mit 20-TB-SATA-Laufwerken ergibt 900 TB raw; mit RAID 6 (doppelte Parität) beträgt die nutzbare Kapazität ca. 860 TB. Dieser Rebuild dauert 24–48 Stunden bei 7.200-RPM-HDDs; während dieses Zeitfensters reduziert ein zweiter Laufwerksausfall die verbleibende Laufwerksredundanz vollständig. Den Pool in kleinere RAID-Z2-vdevs aufzuteilen – drei 15-Laufwerke-vdevs statt einem 45-Laufwerke-Stripe – reduziert die Blast Radius und verkürzt Rebuild-Zeit auf Kosten etwas niedrigerer nutzbarer Kapazität.
Für Performance-orientierte Deployments – Datenbanken, Virtualisierung, Software-Defined-Storage-Knoten – ist die Dimensionierungsbeschränkung IOPS und Durchsatz statt Kapazität. Ein 24-Bay-2U-JBOD mit SAS- oder NVMe-SSDs liefert höhere aggregierte IOPS als ein Hardware-RAID-Controller mit Cache, weil die IOPS jedes Laufwerks direkt zum Pool beitragen. Die Dimensionierung hängt vom Read/Write-Verhältnis des Workloads ab, vom Metadaten-Overhead der Storage-Software und von der Fähigkeit des Hosts, ausreichende Queue Depth über alle Laufwerke gleichzeitig zu treiben. Zu schwache HBAs oder unzureichende CPU-Kerne begrenzen den I/O-Pfad, bevor die Laufwerke es tun.
Dual-Controller-JBOD-Gehäuse werden unter der Annahme von Multipathing- und Failover-Anforderungen dimensioniert. Beide SAS-Links müssen ausreichend Bandbreite haben, um normalen Traffic plus die Failover-Last zu handhaben, wenn ein Pfad ausfällt. Ein 24-Laufwerke-JBOD mit 12-Gbit/s-SAS-Uplinks muss ausreichend Uplink-Bandbreite für den normalen Traffic und die Failover-Last bereitstellen; wenn der Workload normalerweise 1.800 MB/s gesamt pusht, müssen beide Pfade simultan aktiv sein, und der Multipathing-Treiber des Hosts muss Traffic balancieren statt einen Pfad idle zu halten.
Bei server-hardware.com reichen JBOD-Deployments von kompakten 2U-12-Bay Supermicro-JBOD-Gehäusen für Abteilungs-Backup-Server bis zu hochdichten 4U-60-Bay Seagate-JBOD-Shelves für Multi-Petabyte-Storage-Cluster. Die Wahl hängt davon ab, ob Kapazität, Dichte, Redundanz oder Performance die Dimensionierungsbeschränkung dominieren, und ob die Host-Infrastruktur – CPU, RAM, HBA, Storage-Software – den resultierenden Pool verwalten kann, ohne selbst zum Bottleneck zu werden. Angebote für JBOD-basierte Storage-Projekte beinhalten passende HBAs, SAS-Verkabelung und Bestätigung, dass die Host-Plattform die geplante Konfiguration treiben kann; Kompatibilitätsfragen werden direkt vor dem Kauf beantwortet, um Integrationsfehler nach dem Deployment zu vermeiden.
JBOD oder RAID: Die Entscheidung hängt davon ab, wo die Intelligenz angesiedelt sein soll
JBOD ist erfolgreich, wenn Storage-Intelligenz auf Software-Ebene angesiedelt sein soll – in ZFS, in Ceph, in einer Hyperconverged-Plattform, in einem Object Store – anstatt im Gehäuse. Ein JBOD-Gehäuse ist bewusst unintelligent: Es stellt physische Infrastruktur bereit (Bays, Strom, Kühlung, SAS-Switching) und nichts weiter. Diese Einfachheit wird zur Stärke, wenn der Host oder das verteilte System bessere Sicht auf den Workload hat, bessere Redundanz-Algorithmen und bessere Platzierungslogik, als sie ein einzelnes Gehäuse bieten könnte.
Die architektonische Frage ist, ob der Host fähig ist, diese Verantwortung zu übernehmen. Ein einzelner Server mit Software-RAID muss Rebuild-I/O, Path-Failover und Gesundheitsüberwachung ohne die eingebaute Automatisierung eines Controllers handhaben. Ein Hyperconverged-Cluster verteilt diese Komplexität über mehrere Knoten und reduziert die Last pro Knoten, erfordert aber ausgereiftere Storage-Software. Ein Hardware-RAID-Controller lagert alles aus, bindet Sie aber an die Fähigkeiten des Controllers, seine Cache-Größe, seine RAID-Level-Unterstützung und seinen Firmware-Lifecycle.
JBOD ist keine Standardwahl; es ist eine bewusste Wahl. Es passt zu Software-Defined Storage, Scale-out-Architekturen und kapazitätsoptimierten Workloads, bei denen der Host oder Cluster die Expertise und die Ressourcen hat, Laufwerke direkt zu verwalten. Für diese Deployments liefert JBOD die niedrigsten Kosten pro TB, die höchste Konfigurationsflexibilität und die sauberste Integration mit modernen Storage-Plattformen, die rohe Block-Devices erwarten statt vorverarbeitete LUNs.
 Online Marketing Managerin